
José Antonio Bowen – C. Edward Watson
Xuất bản lần thứ hai với sự hợp tác của Hiệp hội các trường đại học và cao đẳng Hoa Kỳ, JOHNS HOPKINS UNIVERSITY PRESS, Baltimore, 2026
A.I. dịch, Thuận Thiên hiệu đính
BIÊN NIÊN SỬ
Thập niên 1950: Nghiên cứu trí khôn nhân tạo khởi động nhưng tập trung vào các hệ chuyên gia hoặc các hệ thống logic.
1959: Arthur Samuel đặt ra thuật ngữ “machine learning” (học máy).
1967: Joseph Weizenbaum tạo ra ELIZA, chatbot quan trọng đầu tiên và là mô hình ngôn ngữ lớn (LLM) đánh dấu sự khởi đầu của các nghiên cứu trong lĩnh vực xử lý ngôn ngữ tự nhiên (NLP).
Thập niên 1990: Nghiên cứu về học sâu (deep learning) và các mạng nơ-ron nhân tạo bắt đầu phát triển mạnh.
1997: Máy Deep Blue của IBM đánh bại Vô địch cờ vua Garry Kasparov.
2010: Demis Hassabis, Shane Legg, và Mustafa Suleyman DeepMind lập ra DeepMind.
2016: Ian Goodfellow đề xuất các mạng đối kháng tạo sinh (Generative Adversarial Network – GAN), từ đó dẫn đến nhiều loại mạng nơ-ron mới vừa có khả năng tạo sinh (tạo dữ liệu) vừa có thể được huấn luyện hiệu quả.
2016: AlphaGo (một hệ AI học máy của DeepMind) đánh bại nhà vô địch thế giới Lee Sedol trong môn cờ vây.
2017: Các mô hình Transformer cho phép vừa giải mã (decode) vừa tạo sinh (generate) văn bản mới.
2018: Mô hình ngôn ngữ lớn GPT đầu tiên được OpenAI phát triển.
2021: DALL·E, được xây dựng trên nền GPT-3, là một mô hình học máy có khả năng tạo sinh hình ảnh.
2022: ChatGPT-3.5 được ra mắt vào tháng 11; các ứng dụng AI bắt đầu bùng nổ.
2023: GPT- 4 được phát hành vào tháng 3, tiếp theo là Bard (sau này là Gemini) của Google, Claude của Anthropic, Llama của Meta, và Grok của X.
2024: Các hệ AI đa phương tiện mới có thể nhìn, nghe, nói và mô phỏng cảm xúc ngày càng theo thời gian thực.
Những khả năng mới như sáng tác bài hát và tạo video ngày càng chân thực cũng phát triển nhanh chóng.
2025: Hầu hết các mô hình ngôn ngữ lớn (LLM) được kết nối với Internet và có thể tìm kiếm theo thời gian thực. Các tác nhân (agent) AI (có khả năng tương tác trực tiếp với tệp và trang web) được giới thiệu. Công ty DeepSeek của Trung Quốc tạo nên một “cơn sốt” AI khi cung cấp miễn phí, mã nguồn mở và được cho là phát triển ít phụ thuộc vào công nghệ Mỹ.
Các nền tảng “nghiên cứu sâu” (deep research), kết hợp giữa tìm kiếm web và quá trình suy luận chậm, có thể truy cập rộng rãi.
GPT-5 được phát hành vào tháng 8.
DẪN NHẬP
“Không có gì trong cuộc sống đáng để sợ hãi, mà chỉ cần được hiểu rõ. Bây giờ là lúc cần hiểu biết nhiều hơn, để chúng ta có thể sợ hãi ít đi”
MARIE CURIE, Giải Nobel Vật lý (1903) và Hoá học (1911)
Có rất nhiều điều cần hiểu về trí tuệ nhân tạo. Cũng giống như Internet, AI là một công nghệ sẽ làm thay đổi mọi thứ, và không chỉ riêng giáo dục.
Internet, cụ thể hơn là World Wide Web, đã làm thay đổi một cách căn bản mối quan hệ của chúng ta với tri thức: từ một thế giới nơi tri thức khan hiếm (nhưng phần lớn đáng tin cậy) sang một thế giới nơi tri thức dồi dào (nhưng phần lớn không đáng tin cậy). Khi cách nhìn này được nêu ra (Bowen, 2006), tất cả chúng ta vẫn đang sử dụng Internet trên máy tính để bàn; iPhone khi đó vẫn chưa xuất hiện. Chúng ta đều nhận thấy lợi ích của việc tiếp cận nhiều hơn với tài liệu nghiên cứu và chuyên môn, nhưng đồng thời cũng đã cảnh giác trước sự gia tăng của thông tin chưa được kiểm chứng và đôi khi mang tính sai lệch, thậm chí độc hại. Và với những hạn chế của kết nối quay số (dial-up), người ta dễ đánh giá thấp mức độ phổ biến sắp tới của công nghệ mới này. Tốc độ, sự dễ dàng trong truy cập và các nền tảng đã thay đổi cơ chế vận hành, đồng thời khuếch đại tác động, nhưng không làm thay đổi quỹ đạo phát triển. Mối quan hệ của chúng ta với tri thức đã thay đổi vĩnh viễn, và từ đó mọi thứ, từ giáo dục và mua sắm đến văn hóa và chính trị, đều bị biến đổi.
Nếu Internet đã thay đổi mối quan hệ của chúng ta với tri thức, thì AI sẽ thay đổi mối quan hệ của chúng ta với tư duy. Nó đã bắt đầu thách thức các quan niệm về sáng tạo và tính nguyên bản, và sẽ làm thay đổi vĩnh viễn giáo dục, công việc, cũng như cách chúng ta suy nghĩ về chính việc suy nghĩ (cả “tư duy” của con người lẫn của AI).
Có lẽ chúng ta có thể rút ra một số bài học từ sự trỗi dậy của Internet. Cũng như các công nghệ về sau (như iPhone và mạng xã hội) đã khuếch đại tác động của Internet, ta có thể giả định rằng AI sẽ ngày càng trở nên tốt hơn và gắn bó chặt chẽ hơn với đời sống của chúng ta trong tương lai. Việc cấm các công cụ dựa trên web như Wikipedia đã thất bại, nhưng liệu Internet có phát triển theo một hướng khác nếu ngay từ đầu chúng ta áp đặt những ràng buộc khác đối với quá trình phát triển của nó?
AI đã thách thức và gây chia rẽ chúng ta nhanh hơn cả Internet trước đây. Một số điều chúng tôi trình bày ở đây có thể đã thay đổi vào thời điểm văn bản này được xuất bản. Tuy vậy, vào năm 2006, chúng ta không cần phải dự đoán chính xác các thiết bị đồng quy hay nền tảng mạng xã hội sẽ xuất hiện, mà vẫn có thể nhận ra rằng độ tin cậy của thông tin sẽ sớm suy giảm. Những biến đổi nhanh chóng lại đang diễn ra, và chúng ta có thể dựa vào những gì AI đã làm được để chuẩn bị cho một tương lai trong đó mối quan hệ của chúng ta với tư duy sẽ bị thay đổi một cách căn bản.
PHẦN I
CHƯƠNG 1
KIẾN THỨC CƠ BẢN VỀ A.I
AI là một trong những điều quan trọng nhất mà nhân loại đang theo đuổi. Nó có ý nghĩa sâu sắc hơn cả điện hay lửa.
SUNDAR PICHAI, CEO của Google và Alphabet
Nếu bạn bận rộn vào ngày 30 tháng 11 năm 2022, có thể bạn đã bỏ lỡ bản trình diễn sớm của OpenAI về chatbot mới của họ. Nhưng chỉ sau năm ngày, hơn một triệu người đã thử nó. Chỉ trong hai tháng, nó đã đạt 100 triệu người dùng hoạt động hằng ngày. TikTok mất chín tháng và Instagram mất hai năm rưỡi để đạt được cột mốc đó (Hu, 2023).
Nhưng lớn hơn cả lửa ư? Sundar Pichai đã nhiều lần đưa ra so sánh này, nhưng ít người trong chúng ta chú ý khi ông nói công khai vào tháng 1 năm 2016, đồng thời thừa nhận rằng ông thực sự chưa hiểu rõ AI hoạt động như thế nào. Lửa, giống như nhiều thành tựu công nghệ khác của loài người, là con dao hai lưỡi: vừa là nguồn gây hủy diệt và biến đổi, vừa là chất xúc tác cho những tiến bộ có lợi. AI hiện cũng đang đi theo một quỹ đạo tương tự.
Hầu hết chúng ta đều đã từng nghe về AI; một số người thậm chí còn nhớ thời điểm một máy tính đánh bại nhà vô địch cờ vua thế giới, nhưng đó là một dạng AI khác. Như thường thấy trong nhiều lĩnh vực (hãy nghĩ đến vắc-xin mRNA), nghiên cứu kéo dài hàng thập kỷ có thể rẽ sang một hướng mới hoặc tìm được ứng dụng mới, và một công nghệ đã phát triển qua nhiều năm bỗng chốc bùng nổ trong nhận thức của công chúng.
Trong nhiều thế kỷ, con người đã tìm kiếm những cách đơn giản để nhóm lại lửa giữa đêm. Những phiên bản hóa học ban đầu, từ Robert Boyle (những năm 1680) đến Jean Chancel (1805), đều đắt đỏ, nguy hiểm hoặc cả hai, và không có loại nào được sản xuất đại trà. Sau đó, vào năm 1826, nhà hóa học John Walker tình cờ phát hiện ra rằng ma sát có thể giúp việc tạo lửa trở nên an toàn và rẻ tiền. Giống như que diêm, bảy mươi năm nghiên cứu học thuật trong AI đã góp phần tạo nên sự bùng nổ nhận thức gần đây, nhưng chỉ trong một khoảnh khắc ngắn ngủi, thế giới của chúng ta đã thay đổi.
Hệ chuyên gia so với học máy
Thuật ngữ “trí khôn nhân tạo” (AI) được đặt ra vào năm 1956 tại một hội nghị do Defense Advanced Research Projects Agency tài trợ, nhằm hình dung, nghiên cứu và tạo ra các máy móc có khả năng thực hiện những nhiệm vụ thường đòi hỏi nhận thức và trí tuệ của con người. (Chúng tôi đã làm nổi bật các thuật ngữ quan trọng khi chúng được định nghĩa lần đầu và tóm tắt chúng trong các bảng thuật ngữ bên lề).
Những nghiên cứu AI ban đầu tập trung vào logic hoặc các hệ chuyên gia (expert systems), sử dụng các quy tắc được thiết kế để dự đoán một loạt các kịch bản có thể xảy ra. Các hệ thống này không cải thiện qua các lần lặp, mặc dù robot và AI thường được miêu tả như vậy trong tiểu thuyết. Ngay cả trong Star Trek, hình ảnh ba chiều y học khẩn cấp cũng luôn bị giới hạn bởi lập trình của nó.
Nhà tiên phong của IBM, Arthur Samuel (1959), đã đặt ra thuật ngữ “học máy” (machine learning) để mô tả các thuật toán thống kê có thể khái quát hóa và “học cách chơi cờ đam tốt hơn người đã viết ra chương trình đó”. Đối với một trò chơi đơn giản như cờ đam, người ta có thể phát triển một hệ chuyên gia có khả năng tìm kiếm trong cơ sở dữ liệu, đồng thời đưa ra suy luận vượt ra ngoài các lời giải sẵn có. Tuy nhiên, chương trình cờ đam của Arthur Samuel “chỉ được cung cấp các luật của trò chơi, một định hướng chung, và một danh sách tham số dư thừa và chưa đầy đủ, được cho là có liên quan đến trò chơi, nhưng dấu và trọng số tương đối chính xác của chúng thì chưa được biết và cũng không được xác định” (Samuel, 1959).
Ban đầu, các hệ chuyên gia (cùng với suy luận logic của chúng) chiếm ưu thế trong nghiên cứu, nhưng học máy (với suy luận xác suất) lại hữu ích hơn trong việc nhận diện các mẫu; do đó, nó trở thành một phần trung tâm hơn của nghiên cứu AI vào những năm 1990 (Langley, 2011). Với dung lượng bộ nhớ lớn hơn và các tập dữ liệu ngày càng lớn, các thuật toán thống kê có thể suy ra chẩn đoán y khoa (ví dụ như WebMD), và cuối cùng dẫn đến chương trình cờ vua Deep Blue của IBM đánh bại nhà vô địch cờ vua Garry Kasparov vào năm 1997.
Học máy + Mạng nơ-ron = Các mô hình nền tảng
Mạng nơ-ron là các hệ thống tính toán được mô phỏng theo cách các kết nối thần kinh trong não người hoạt động. Chúng là một dạng cụ thể của mô hình học máy, trong đó các nút (những đơn vị tính toán riêng lẻ) được tổ chức thành các lớp, phản ánh hiểu biết của chúng ta về cấu trúc não bộ. Vào những năm 1960–1970, các mạng này mang tính logic và tuyến tính, theo kiểu “nếu–thì” (giống như làm theo chỉ dẫn từ GPS), nhưng ngày nay chúng đã trở thành các tầng phi tập trung gồm những nút liên kết với nhau (giống như có nhiều con đường khác nhau để đi từ điểm này đến điểm khác).
Các mạng nơ-ron cần được huấn luyện, thường trên các tập dữ liệu lớn. Việc huấn luyện này có thể là “có giám sát” (supervised), trong đó dữ liệu được được dán nhãn để mô hình học các mối liên hệ giữa đầu vào và đầu ra mong muốn, hoặc là “không giám sát” (unsupervised), trong đó dữ liệu đầu vào không được dán nhãn. Khi một mô hình có giám sát đã được huấn luyện, nó có thể phân loại các đầu vào mới: đây chính là cách bộ lọc thư rác của bạn hoạt động. Học máy không giám sát thường đòi hỏi các tập dữ liệu lớn hơn, nhưng sau đó có thể phát hiện và nhóm các xu hướng và mối quan hệ chưa từng thấy: bạn xem Netflix càng nhiều, hệ thống càng tìm ra các liên kết giữa những nội dung bạn thực sự thích (và nhận ra rằng bộ phim tài liệu về cá vàng mà bạn đã lưu lại có lẽ là một nhầm lẫn).
Một mô hình học máy thứ ba (bên cạnh học có giám sát và không giám sát) là học tăng cường (reinforcement learning – RL). Trong trường hợp này, các mạng nơ-ron thường được cung cấp lượng dữ liệu không dán nhãn nhỏ hơn, nhưng cho phép thuật toán tương tác với một môi trường, trong đó trong đó những đầu ra cụ thể được “thưởng”: khi bạn nhấp vào quảng cáo trên Facebook, bạn sẽ có nhiều khả năng thấy lại những quảng cáo tương tự.
Học sâu (deep learning – DL) là một kỹ thuật huấn luyện liên quan, trong đó “deep” (sâu) đề cập đến nhiều tầng của mạng cần thiết để biến đổi dữ liệu; các nhiệm vụ đơn giản hơn nằm ở các tầng sâu hơn trong mạng, rồi kết hợp lại để tạo ra đầu ra. Ví dụ, trong nhận diện khuôn mặt, mô hình trước hết phải nhận ra những nhóm điểm ảnh nào tạo thành khuôn mặt, trước khi có thể trích xuất các đặc trưng và cuối cùng đối sánh chúng với những khuôn mặt đã biết. Những kỹ thuật học máy này phản ánh cả ưu điểm lẫn hạn chế của cách con người học tập. DeepMind có trụ sở tại London, hiện là công ty con của Google, hoàn toàn có thể dạy mạng Deep Q-Network của mình chơi các trò chơi điện tử như Pong bằng cách lập trình sẵn các luật (cách tiếp cận của hệ chuyên gia). Cách này (giống như gian lận) sẽ nhanh hơn, nhưng bằng cách sử dụng những kỹ thuật thử–sai chậm hơn, mạng Deep Q-Network giờ đây có thể khái quát hóa và, giống như con người, học cách chơi các trò Atari tiếp theo nhanh hơn nhiều. Vì mô hình học trực tiếp từ dữ liệu, nó cũng có thể tạo ra chiến lược theo những cách không bị giới hạn bởi các giả định của con người (điều này có hàm ý đối với cả tính sáng tạo [xem Chương 4] lẫn độ chính xác [xem bên dưới]). Những chương trình của DeepMind mất nhiều thời gian hơn để tự học, nhưng cuối cùng đã vượt qua khả năng của con người (Mnih và cộng sự, 2015).
Khi kết hợp lại, các mạng nơ-ron sâu và các kỹ thuật học máy cho phép chúng ta xây dựng các mô hình nền tảng. Vì chúng được huấn luyện trên những tập dữ liệu rất lớn và đa dạng, chúng là các hệ thống có mục đích chung với những năng lực rộng mà chúng ta vẫn đang tiếp tục khám phá: ít ai dự đoán rằng những mô hình mới này có thể giải mã các bản quét não (sử dụng fMRI) để tái tạo lại những hình ảnh mà người tham gia đang nhìn (Chen, 2022; Takagi & Nishimoto, 2023). Một phần khiến công nghệ AI mới trở nên khác biệt, và có thể nguy hiểm, là chúng ta vẫn đang khám phá những gì nó có thể làm.
Các mô hình ngôn ngữ lớn (LLM) là những mô hình nền tảng ban đầu tập trung vào ngôn ngữ, nhưng đồng thời cũng mở ra những cách mới để phân tích DNA, âm nhạc, mã máy tính và sóng não. Các mô hình nền tảng khác nhau (như ChatGPT hay Gemini) “tư duy” theo những cách khác nhau (giống như việc so sánh Marie Curie với Cesar Chavez). Mạng nơ-ron của chúng khác nhau và chúng cũng được huấn luyện theo những cách khác nhau: nói một cách ẩn dụ, chúng khác nhau cả về “bẩm sinh” lẫn “nuôi dưỡng”.
Phép thử Turing và tư duy của AI
Alan Turing lần đầu đặt ra câu hỏi “Máy móc có thể suy nghĩ không?” trong bài báo Computing Machinery and Intelligence (Alan Turing, 1950). Turing lập luận rằng vì “tư duy” là một khái niệm khó định nghĩa, nên câu hỏi ban đầu của ông là không có ý nghĩa, và ông thay thế nó bằng một phiên bản của “trò chơi bắt chước” (imitation game), trong đó người hỏi đặt câu hỏi cho hai đối tượng và nhận câu trả lời — tất cả đều thông qua văn bản trên màn hình máy tính. Trong biến thể của Turing, một đối tượng là con người và đối tượng còn lại là AI; người hỏi cố gắng xác định đâu là con người. Điều mà ngày nay chúng ta gọi là “phép thử Turing” không thực sự nói về tư duy, ý thức, trí tuệ, sự hiểu biết hay cảm nhận, cũng không liên quan đến cách một chương trình xử lý thông tin; điểm đổi mới của Turing là thay thế câu hỏi “Máy móc có thể suy nghĩ không?” bằng câu hỏi: “Liệu chatbot này có thể khiến chúng ta tin rằng mình đang tương tác với một con người hay không?”
Năm 2022, kỹ sư của Google, Blake Lemoine, đã bị sa thải vì tuyên bố rằng chatbot của Google đã trở nên có cảm nhận (sentient) (Grant & Metz, 2022): một ví dụ rõ ràng cho thấy nó đã “vượt qua” phép thử Turing. Một hệ AI không phải suy nghĩ: việc tin rằng một chatbot có cảm nhận là đủ.
Các mô hình ngôn ngữ lớn (LLM) sử dụng sự kết hợp của nhiều công nghệ để mô phỏng ngôn ngữ và cảm xúc của con người, đồng thời dự đoán từ tiếp theo (hoặc ngữ điệu), bao gồm các mạng nơ-ron sâu mô phỏng cách con người học, tốc độ và dung lượng tính toán ngày càng tăng, khối lượng dữ liệu khổng lồ do con người tạo ra, và sự quay trở lại nhấn mạnh vào chiến lược học máy dựa trên xác suất và thống kê. Tương tự như việc tạo ma sát trong que diêm tạo ra lửa theo một cách mới, việc tái tập trung vào xác suất và học máy vào những năm 1990 đã mở ra cánh cửa cho AI tạo sinh mới. Sau khi tiếp xúc với GPT-3 vào năm 2020, triết gia David Chalmers đã viết rằng “nó gợi ý một con đường tiềm năng không cần ‘tâm trí’ để đạt tới trí khôn nhân tạo tổng quát (AGI)” (Chalmers, 2020). ChatGPT là một bước đột phá, nhưng nó cũng được xây dựng dựa trên những sự nhân nhượng.
BẢNG THUẬT NGỮ I
Trí khôn nhân tạo (AI) đề cập đến khả năng của các hệ thống máy tính trong việc mô phỏng trí khôn con người, cũng như việc phát triển các hệ thống như vậy.
Hệ chuyên gia (expert systems) sử dụng các quy tắc và logic để dự đoán một loạt các kịch bản có thể xảy ra.
Học máy (machine learning) sử dụng xác suất và thống kê để nhận diện các mẫu và khái quát hóa.
Mạng nơ-ron (neural networks) là các hệ thống tính toán được mô phỏng theo các kết nối thần kinh trong não người.
Các mô hình nền tảng (foundational models) là các mạng nơ-ron sâu được huấn luyện trên các tập dữ liệu lớn bằng các kỹ thuật học máy mô phỏng quá trình thử & sai của con người.
Các mô hình ngôn ngữ lớn (LLM) là các mô hình nền tảng tập trung vào ngôn ngữ.
GPT là viết tắt của generative pre-trained transformer (mô hình biến đổi được huấn luyện trước để tạo sinh). Các mô hình nền tảng và LLM đều sử dụng kiến trúc GPT; nó không chỉ riêng của ChatGPT.
Các mô hình khuếch tán (diffusion models) là một loại mô hình nền tảng được dùng để tạo hình ảnh và video. Các công cụ như DALL·E, Stable Diffusion và Midjourney được huấn luyện bằng cách thêm nhiễu vào dữ liệu huấn luyện, sau đó mô hình học cách loại bỏ nhiễu đó.
Ảo giác và thiên kiến: chữ “G” và chữ “P” trong GPT
Quá trình tiền huấn luyện (pre-training: chữ “P” trong generative pre-trained transformer, hay các mô hình GPT) của một hệ AI kéo dài và đòi hỏi một tập dữ liệu khổng lồ (GPT-3 được huấn luyện trên 45 terabyte dữ liệu văn bản: hơn 12 nghìn tỷ từ). Đó cũng là lý do vì sao các mô hình ngôn ngữ lớn được gọi là “lớn”. Vì các nguồn dữ liệu tiền huấn luyện (bao gồm bộ dữ liệu Common Crawl được thu thập hằng tháng từ hàng tỷ trang web) chứa cả những mặt tốt, xấu và tiêu cực của tư duy con người, và vì các LLM học bằng cách hấp thụ dữ liệu để dự đoán, nên chúng tất yếu sẽ tái tạo lại những thiên kiến và thù ghét có trong nguồn dữ liệu đó.
AI cũng có thể khuếch đại các thiên kiến trên Internet. Khi Stable Diffusion, một hệ AI có khả năng tạo ra hình ảnh giống y như thực từ mô tả văn bản, được yêu cầu tạo hình ảnh liên quan đến các công việc có thu nhập cao, các hình ảnh tạo ra thường là những người (nam giới nhiều gấp ba lần phụ nữ) có làn da sáng hơn so với khi được yêu cầu về các công việc thu nhập thấp. Khi được yêu cầu tạo hình ảnh về “bác sĩ”, chỉ có 7% hình ảnh là phụ nữ, trong khi tại Mỹ, 39% bác sĩ là nữ: Stable Diffusion đã phóng đại những bất bình đẳng vốn có, điều này điều này thể hiện rõ trong các hình ảnh có trong bộ dữ liệu huấn luyện từ Internet (Nicoletti & Bass, 2023). Những hình ảnh do các hệ tạo ảnh AI khác tạo ra cũng cho thấy các thiên kiến tương tự.
Trình tạo ảnh AI Adobe Firefly cố gắng khắc phục điều này bằng cách điều chỉnh số lượng hình ảnh, chẳng hạn phụ nữ hoặc bác sĩ da đen, sao cho tương ứng với tỷ lệ của nhóm đó trong dân số Mỹ: một nửa số hình ảnh bác sĩ mà nó tạo ra là phụ nữ, và 14% là bác sĩ da đen, mặc dù trên thực tế chỉ có 6% bác sĩ ở Mỹ là người da đen (Howard, 2023).
Firefly đã được huấn luyện để tăng xác suất khi yêu cầu tạo hình ảnh một thẩm phán Tòa án Tối cao vào năm 1960, kết quả sẽ là phụ nữ, mặc dù phải đến năm 1981, Sandra Day O’Connor mới trở thành người phụ nữ đầu tiên được bổ nhiệm vào tòa án này.
Sự thiên kiến có thể xuất phát từ dữ liệu huấn luyện, nhưng những ví dụ về thiện chí của Adobe Firefly lại làm nổi bật một loạt vấn đề tiềm ẩn khác: Những người đánh giá (reviewer) là con người, những người chấm điểm và cung cấp phản hồi cho đầu ra của mô hình, cũng mang thiên kiến. (Và công sức lao động nặng nhọc của họ thường bị bỏ qua). Nếu AI có thể tạo ra hình ảnh về thế giới như nó có thể là hoặc như nó đang là, thì ai sẽ là người quyết định? Thiên kiến cũng có thể ẩn trong kiến trúc mạng, các thuật toán giải mã, mục tiêu của mô hình, và đáng lo hơn, trong những tiềm năng chưa được khám phá của các mô hình này. Mọi thứ còn phức tạp hơn bởi chính thiên kiến của người dùng AI, khi các CÂU LỆNH và lựa chọn cuối cùng của họ có thể tiếp tục củng cố thiên kiến trong sản phẩm cuối cùng. Một vấn đề khác là tính “nịnh bợ” (sycophancy): ngay cả khi AI đúng, bạn vẫn thường có thể khiến nó đồng ý với một câu trả lời sai của bạn. Thách thức về thiên kiến của con người trong nội dung AI tồn tại trong trong mọi diễn trình và ở mọi giai đoạn.
Chữ G trong Generative Pre-trained Transformer là viết tắt của “tạo sinh” (generative). Bởi vì các mô hình này “tạo ra” những câu, hình ảnh và ý tưởng mới bằng cách sắp xếp xác suất của từ hoặc điểm ảnh tiếp theo, chúng cũng dễ “tạo ra” dữ liệu sai hoặc “bịa đặt” các tham chiếu hư cấu.
Khả năng “ảo giác” này khiến AI trở thành một công cụ tuyệt vời cho sáng tạo: nó có thể kết hợp ý tưởng và ngôn từ theo những cách mà con người có thể chưa từng nghĩ tới (sẽ bàn thêm ở chương 4). Điều quan trọng cần lưu ý là “ảo giác” không phải là lỗi. Chúng là một đặc tính — thường gây phiền toái — đòi hỏi sự giám sát cẩn trọng của con người. Chính đặc điểm thiết kế này, cho phép các mô hình ngôn ngữ lớn đưa ra những câu trả lời mới và khác nhau cho cùng một CÂU LỆNH, cũng dẫn đến tính khó đoán và độ tin cậy thấp. Mills và Angell (2025) gọi hiện tượng này là “ảo ảnh” (mirage).
AI cũng có thể tạo ra thông tin sai lệch.
Các mô hình mới hơn đã giảm bớt cả hai vấn đề này, nhưng rất khó để loại bỏ hoàn toàn tính khó đoán và sự thiếu tin cậy: cả hai đều là hệ quả trực tiếp của cách mà AI học để bắt chước cách suy nghĩ của con người. Thiên kiến phần lớn là kết quả của giai đoạn “tiền huấn luyện” (pre-training), còn khả năng “ảo giác” thì nằm ngay trong bản chất “tạo sinh” của Generative Pre-trained Transformer.
Transformer: “bộ não” của GPT
Việc hiểu cơ chế Transformer (một loại mô hình, không phải robot trong phim) khó hơn và cũng dẫn chúng ta tới các khái niệm như “tham số” (parameters) và “token”.
Mỗi biến nội tại trong một mạng nơ-ron có thể được điều chỉnh để thay đổi đầu ra đều được gọi là một tham số. Một ví dụ đơn giản của tham số là số lượng từ có thể xuất hiện tiếp theo trong một câu. Còn siêu tham số (hyperparameter) là cấu hình các biến như mức độ ngẫu nhiên, sáng tạo, hay “nhiệt độ” (temperature) quyết định phản hồi nào được chọn. Khi “nhiệt độ” được đặt bằng 0, mô hình trở nên mang tính xác định cao nhất: nó sẽ chọn từ tiếp theo có xác suất cao nhất. Ở các mức nhiệt độ cao hơn, những từ có xác suất thấp hơn cũng có thể được chọn, dẫn đến sự sáng tạo và đa dạng lớn hơn, nhưng đồng thời cũng làm tăng khả năng xuất hiện nội dung vô nghĩa và “ảo giác”. Một mô hình được huấn luyện bằng cách cung cấp cho nó các ví dụ và điều chỉnh các tham số để thay đổi đầu ra.
Generative Pre-trained Transformer-2 có 1,5 tỷ tham số, GPT-3 có 175 tỷ tham số, và GPT-4 được ước tính có khoảng 1,76 nghìn tỷ tham số cùng dung lượng bộ nhớ lớn hơn đáng kể (Geyer, 2023; Griffith, 2023). Nhiều tham số hơn cho phép nhiều lựa chọn và sắc thái hơn, vì vậy GPT-4 thông minh hơn, chính xác hơn, hỗ trợ nhiều ngôn ngữ hơn và mang tính đa phương thức (có thể tiếp nhận đầu vào dạng hình ảnh hoặc âm thanh).
GPT-4 đã vượt qua “kỳ thi luật sư” (bar exam: ý nói vượt qua bài kiểm tra năng lực trí tuệ cao cấp – ND), với kết quả tốt hơn phần lớn con người (Katz và cộng sự, 2023), và GPT-5 đã bổ sung cơ chế định tuyến tự động (automatic routing), giúp xác định mô hình phù hợp nhất cho yêu cầu của bạn. Các mô hình lớn hơn giờ đây có thể trò chuyện với bạn trong khi quan sát bạn làm việc (trên màn hình hoặc sửa một chiếc xe đạp), nhưng nhiều tham số hơn cũng có thể khiến mô hình chậm hơn và tiêu tốn nhiều năng lượng hơn.
Một mạng nơ-ron chỉ xử lý các con số, vì vậy từ ngữ (hoặc hình ảnh hay tín hiệu não) cần được chuyển thành các token, tức là dạng đại diện số hóa. Token là chuỗi các số 0 và 1 biểu diễn từ, một phần của từ, hoặc dữ liệu khác. Nhiều token hơn đồng nghĩa với nhiều từ vựng, ngữ cảnh và sắc thái hơn, nhưng cả quá trình chuyển đổi từ thành số (“tokenization”) lẫn kích thước mô hình đều rất quan trọng. Các mô hình lớn nhất hiện nay cho phép bạn tải lên hàng triệu từ để phân tích cùng lúc.
AI xác định ý nghĩa của một token bằng cách quan sát nó trong ngữ cảnh (tức là xem những token khác, từ hoặc hình ảnh, xuất hiện gần nó và tần suất xuất hiện). Ban đầu, mỗi từ trong một chuỗi được xử lý tuần tự. Bước đột phá năm 2017 với kiến trúc Transformer (chữ “T” mà bạn đang chờ đợi) đã cung cấp cho mỗi token một một trọng số thể hiện mức độ quan trọng của ngữ cảnh của token đó so với các token khác (Uszkoreit, 2017; Vaswani và cộng sự, 2017). Cơ chế “tự chú ý” (self-attention) này cho phép mỗi từ được xử lý đồng thời, giúp tăng tốc độ đáng kể và tạo ra cách nắm bắt ngữ cảnh “tự nhiên” hơn.
Kiến trúc Transformer cho phép AI không chỉ xét xác suất của token tiếp theo, mà còn xem xét đồng thời nhiều tổ hợp token và các mẫu lớn hơn. Transformer đã mở đường cho các mô hình ngôn ngữ lớn (LLM) có khả năng tạo ra văn bản giống con người, đồng thời thống nhất nhiều lĩnh vực rời rạc của AI thành một lĩnh vực chung, nơi mọi thứ – từ hình ảnh, mã lập trình, âm nhạc đến DNA – đều có thể được xử lý như ngôn ngữ.
Sự đồng bộ này (gợi nhắc đến những dự đoán về sự đồng quy hay “điểm kỳ dị”) là một trong những lý do khiến LLM trở thành các mô hình nền tảng trung tâm, và cũng là lý do vì sao sự thay đổi dường như diễn ra rất nhanh. Việc công chúng có thể tiếp nhập một hệ thống Generative Pre-trained Transformer hoạt động vào ngày 30 tháng 11 năm 2022 cũng góp phần hình thành tri nhận đó.
BẢNG THUẬT NGỮ II
Xử lý ngôn ngữ tự nhiên (NLP) là một lĩnh vực của AI và ngôn ngữ học, nhằm giúp máy móc hiểu, diễn giải và tạo ra ngôn ngữ của con người. Những khả năng này rất quan trọng đối với các công cụ tìm kiếm và việc phân tích nội dung mạng xã hội của bạn. Các mô hình ngôn ngữ lớn (LLM) sử dụng NLP để huấn luyện các mạng nơ-ron sâu, đồng thời chính LLM cũng được ứng dụng trong các bài toán NLP.
Tham số (parameters) là các biến nội tại trong một mạng nơ-ron, có thể được điều chỉnh để thay đổi đầu ra.
Token là các biểu trưng của từ, một phần của từ, ký tự hoặc dấu câu trong dạng mã hóa, và là trọng tâm của NLP.
Transformer (hay cơ chế “tự chú ý” – self-attention) cung cấp cho mỗi token một trọng số, cho phép các token được so sánh với bất kỳ token nào khác một cách đồng thời.
Giao diện lập trình ứng dụng (API) là một tập hợp các công cụ để xây dựng các ứng dụng phần mềm có thể tương tác với một mô hình nền tảng. Phần lớn các công cụ và sản phẩm AI mà chúng ta đang sử dụng không phải là LLM tự thân, mà được vận hành bởi các LLM nền tảng phía sau.
Tinh chỉnh (fine-tuning) là quá trình cá thể hoá các mô hình nền tảng đã được huấn luyện trước (thông qua API) để thực hiện những nhiệm vụ cụ thể. Ở đây có một sự không hoàn toàn rõ ràng, nhưng với đa số người dùng, có thể hiểu rằng ChatGPT là một hệ thống được tinh chỉnh hoặc được vận hành dựa trên Generative Pre-trained Transformer, chứ không phải là một LLM hoàn toàn riêng biệt.
RAG (retrieval-augmented generation) nghĩa là mô hình sẽ sử dụng một cơ sở tri thức được chỉ định làm nguồn cho các câu trả lời của nó.
Nghiên cứu sâu (Deep research) là sự kết hợp giữa khả năng tìm kiếm trên web (hoặc các công cụ khác như cơ sở tri thức) cùng với một diễn trình xử lý chậm hơn và kiểm tra dữ liệu (đôi khi được gọi là “lập luận” – reasoning).
Tác nhân (Agent) là một loại công cụ AI có thể thực hiện chuỗi các nhiệm vụ hoặc quyết định vượt ra ngoài cửa sổ trò chuyện. Một chatbot có thể lập danh sách nhà hàng; còn một agent có thể đặt bàn.
Trí khôn nhân tạo tạo sinh (GAI) là bất kỳ loại AI nào sử dụng các mô hình học sâu để tạo ra nội dung mới. Các mô hình ngôn ngữ lớn (LLM) và mô hình khuếch tán (diffusion models) đều là ví dụ của GAI.
Trí khôn nhân tạo tổng quát (AGI) là “chén thánh” của khoa học máy tính: một ngày nào đó, AI sẽ có thể suy nghĩ, đưa ra quyết định, thậm chí cảm nhận như con người. Về cơ bản, nó giống như một con người.
Tìm kiếm, Lập luận và Agent
Google truyền thống muốn đưa bạn đến các trang web khác, nhưng AI lại muốn bạn ở lại và đọc nội dung do chính nó tạo ra (đó là lý do vì sao các nhà sáng tạo nội dung muốn bù đắp doanh thu bị mất khi người dùng dừng lại ở kết quả do AI cung cấp). Ban đầu, AI không thể tìm được thông tin cập nhật: nó chỉ dự đoán (và thường “bịa ra”) câu trả lời dựa trên các mẫu mà nó học được từ việc thu thập dữ liệu trên internet trong quá trình huấn luyện.
Perplexity AI là một công cụ sớm kết hợp AI với khả năng tìm kiếm trên internet, nhưng đến đầu năm 2025, hầu hết các mô hình nền tảng đều đã có khả năng này (dù đôi khi bạn phải nhấn nút để kích hoạt). Perplexity cung cấp nhiều loại tìm kiếm khác nhau: web, học thuật, mạng xã hội và tài chính (có thể sắp tới sẽ có tìm kiếm y khoa và nhiều loại khác).
Google đang cố gắng biến việc tìm kiếm web thành một hoạt động được AI hỗ trợ hoặc thậm chí thay thế hoàn toàn, bao gồm cả việc tích hợp vào Google Ads (Amalia, 2024), và có một phạm vi rất rộng các trình duyệt AI mới. Khả năng tìm kiếm trên web có thể cải thiện đáng kể độ xác thực của thông tin, dù nó cũng đòi hỏi những kỹ năng viết CÂU LỆNH khác (sẽ được đề cập ở chương 3).
Một cách khác để tập trung câu trả lời và tăng độ tin cậy là giới hạn tương tác của AI trong một cơ sở tri thức cụ thể, như một tập hợp tệp, dữ liệu hoặc tài liệu. Điều này được gọi là RAG (retrieval-augmented generation).
Một ví dụ phổ biến là NotebookLM của Google, cho phép người dùng tải lên các nguồn tài liệu và sau đó chỉ trò chuyện xoay quanh nội dung của “sổ tay” này.
Cả tìm kiếm (search) và RAG nhanh chóng được kết hợp với các thuật toán mới, trong đó tích hợp yêu cầu mô hình ngôn ngữ lớn (LLM) phải thực hiện nhiều bước tìm kiếm và kiểm tra thông tin trong quá trình xử lý. Việc thêm các chỉ dẫn từng bước trước đây được gọi là “chain-of-thought” CÂU LỆNH, nhưng sau đó các nút mới như “thinking” hoặc “reasoning” bắt đầu xuất hiện, đồng thời nội tại hóa yêu cầu “chậm lại và suy nghĩ cẩn thận hơn”.
Các tính năng tìm kiếm và “lập luận” này tiếp tục được kết hợp thành “deep reasoning” (lập luận sâu). Chế độ đặc biệt này mất nhiều thời gian hơn đáng kể, nhưng có thể kết hợp việc nghiên cứu, kiểm chứng và phân tích để tạo ra các báo cáo chuyên sâu. Điều này cũng đòi hỏi các kỹ thuật viết CÂU LỆNH khác.
AI đa phương thức (multimodal) cho phép bạn khai thác báo cáo theo những cách mới: bạn có thể nghe (hoặc tương tác với) một podcast mang tính trò chuyện, xem sơ đồ tư duy (mind map), hoặc tạo một đồ hoạ thông tin (infographic).
Thêm vào đó khả năng thực hiện và kiểm tra các nhiệm vụ ở từng giai đoạn, chúng ta có AI agent. Vào tháng 11 năm 2022, ChatGPT khiến chúng ta nghĩ về AI như các chatbot — có tính tương tác nhưng chỉ ở dạng văn bản và phần lớn phản hồi theo những gì ta yêu cầu. Ngay cả chế độ giọng nói hay khả năng tạo hình ảnh, video vẫn diễn ra trong một “cửa sổ” tương tác, nhưng agent sử dụng một lớp ứng dụng bao bọc (application wrapper) cho phép chúng thực hiện những việc như theo dõi bài tập của sinh viên.
Agent giống như những “nhà thầu tự động” cho các tác vụ điện tử. Một chatbot có thể viết mã, nhưng một agent có thể chạy đoạn mã đó rồi xây dựng và xuất bản trang web. Một chatbot có thể tạo danh sách việc làm, nhưng một agent có thể nộp đơn ứng tuyển. Nói cách khác, chatbot năm 2023 của bạn có thể bắt đầu bằng việc tìm kiếm các mẫu trong văn bản hoặc quét dựa trên các trọng số xác suất từ một quá trình huấn luyện quy mô lớn; nhưng đến năm 2025, cùng một mô hình ngôn ngữ lớn (LLM) đó còn có thể tìm kiếm trên web các hình ảnh tương tự, kiểm tra câu trả lời của chính nó, xem xét thiên kiến của mình, rồi quyết định liệu có cần gửi email cho một chuyên gia hay không.
Công cụ và đánh đổi
Vậy nên dùng mô hình nào? Hiện nay có hàng nghìn sản phẩm, mô hình và công cụ GenAI. (Danh sách các công cụ và mô hình, cả tổng quát lẫn chuyên biệt, được cập nhật thường xuyên trên trang web của chúng tôi.) Một số mô hình sáng tạo hơn trong việc viết lách, trong khi những mô hình khác lại giỏi hơn về toán học hoặc video. Các mô hình chuyên biệt cung cấp khả năng hội thoại chân thực hơn (Sesame), tạo infographic tốt hơn (Napkin), hoặc các công cụ nghiên cứu khoa học (Future House), nhưng nếu bạn muốn dùng một mô hình duy nhất, thì “ba ông lớn” – ChatGPT của OpenAI, Gemini của Google, và Claude của Anthropic – vẫn cung cấp những khả năng toàn diện nhất trong một nền tảng.
Tất cả đều có các phiên bản chậm, trung bình và nhanh (chậm để phân tích, trung bình cho hầu hết tác vụ, và nhanh để trò chuyện khi bạn chỉ cần một ý tưởng nhanh). “Ba ông lớn” này cũng cung cấp những tính năng tiêu chuẩn nhất trong cùng một nơi: các mô hình lập luận và nghiên cứu sâu, chế độ giọng nói, chế độ thị giác (để xem hình ảnh và tài liệu), khả năng tạo hình ảnh, tài liệu và mã (và chạy mã), cùng với ứng dụng di động.
Có các công cụ chuyên biệt cho video (như Hailou, Kling và Veo 3 của Google), nhưng bạn cũng có thể tạo video trực tiếp trong các mô hình này; việc tạo hình ảnh hoặc video trong một mô hình đa phương thức thông minh giúp việc viết CÂU LỆNH dễ hơn, nhưng lại cung cấp ít công cụ mang tính điện ảnh hơn.
Các tính năng, mô hình và những gì bạn được sử dụng miễn phí thay đổi liên tục (và tên gọi cũng như vị trí của các mô hình thường khá rối rắm). Bạn sẽ cần tìm kiếm qua các nút và menu chạy xuống (drop-down menus) để thấy thứ mình cần; cũng lưu ý rằng các tính năng đôi khi kết hợp theo những cách khá “kỳ lạ”: ví dụ, chế độ giọng nói có thể tắt chức năng tìm kiếm.
Bạn sẽ cần đăng nhập, ngay cả với phiên bản miễn phí, nhưng điều này cũng cho phép bạn điều chỉnh cài đặt để bật các tính năng bảo mật. Bạn cũng có thể cá nhân hóa phản hồi bằng system CÂU LỆNH, các phong cách viết hoặc “tính cách” khác nhau (xem chương 3). Bạn có thể muốn hoặc không muốn ChatGPT ghi nhớ mọi thứ về bạn để phản hồi tốt hơn.
Bạn nên thử phiên bản trả phí trong một tháng để khám phá. (Các nền tảng tổng hợp như Poe, BoodleBox cho phép bạn dùng thử nhiều mô hình khác nhau trên cùng một nền tảng với một khoản phí.)
Ngoài ra, hãy thử ứng dụng trên điện thoại: khả năng nhận trợ giúp khi sửa máy hút bụi hoặc tìm điều khiển từ xa có thể không quá quan trọng, nhưng nó sẽ giúp bạn có được một hình dung rõ hơn về việc AI sắp thay đổi mọi thứ như thế nào. (Bạn có thể tìm danh sách cập nhật các công cụ và API trên trang web của chúng tôi.)
Grok ban đầu kém hơn nhưng đã bắt kịp. Nó có ít rào chắn an toàn hơn và mang tính châm biếm nhiều hơn. Nếu bạn muốn tóm tắt tin tức gần đây, Gemini có thể tìm kiếm nguồn tin AP với quyền truy cập được cấp phép, còn Grok thì lấy thông tin theo thời gian thực từ X (trước đây là Twitter). Nếu bạn muốn biết sinh viên đang nói gì về kỳ thi cuối kỳ của bạn, mạng xã hội có thể là nguồn tốt hơn.
Microsoft, Apple và Meta đều có phần tụt lại phía sau vào năm 2025. Microsoft sở hữu một phần lớn OpenAI, vì vậy Microsoft Copilot về cơ bản là một phiên bản của ChatGPT được tích hợp với các sản phẩm của Microsoft. Nếu tổ chức của bạn đã đăng ký một công cụ AI cho toàn trường, rất có thể nó tuân thủ Family Educational Rights and Privacy Act (FERPA), nghĩa là phiên bản đó của công cụ sẽ không lưu trữ CÂU LỆNH và dữ liệu bạn tải lên trên máy chủ của nó. Microsoft là đơn vị đầu tiên cung cấp phiên bản công cụ ở cấp độ doanh nghiệp tuân thủ FERPA (với Microsoft Copilot), nhưng hiện nay nhiều công ty khác cũng đã làm được điều này, bao gồm một số nền tảng tổng hợp AI đã đề cập ở trên. Khi bạn cân nhắc tải lên bài làm của sinh viên hoặc nghiên cứu mới nhất của mình để nhờ AI hỗ trợ, bạn nên đặt câu hỏi tại cơ sở của mình về mức độ tuân thủ FERPA.
DeepSeek mã nguồn mở đã làm dấy lên nhận thức mới về năng lực của Trung Quốc khi trở thành ứng dụng được tải xuống nhiều nhất trong một thời gian vào đầu năm 2025. Câu chuyện của họ khá đáng chú ý. Mỹ đã thành công trong việc hạn chế bán các chip AI tiên tiến nhất của NVIDIA cho China, nhưng DeepSeek lại tập trung vào các kỹ thuật huấn luyện sáng tạo và nguồn nhân lực trong nước (gần như tất cả đều được đào tạo tại Trung Quốc [Zegart & Johnston, 2025]).
Liên quan đến điều này, Trung Quốc đã đầu tư mạnh mẽ để phát triển các công nghệ không phụ thuộc vào bên ngoài quốc gia. Huawei Technologies đã cải thiện các công nghệ bán dẫn của họ và tuyên bố rằng các chip AI hiện nay có thể cạnh tranh với các chip cao cấp của NVIDIA (Si, 2025). Những tiến bộ này đã giúp DeepSeek vượt lên trước LLaMA – dòng mô hình ngôn ngữ mã nguồn mở của Meta không yêu cầu đăng nhập hay đăng ký.
Dù thiếu một số tính năng so với “ba ông lớn” của Mỹ, DeepSeek lại nhanh hơn và tiêu tốn ít năng lượng hơn. Giống như trong lĩnh vực xe điện, Trung Quốc đã khuyến khích và hỗ trợ mạnh mẽ sự cạnh tranh trong AI. Có nhiều mô hình mạnh mẽ của Trung Quốc như Kimi, Qwen, Doubao, Ernie và Minimax (cũng phát triển một công cụ video hàng đầu là Hailou). Cuộc cách mạng agent năm 2025 được dẫn dắt bởi Manus và Genspark, đều do các công ty Trung Quốc phát triển.
Quan điểm ban đầu cho rằng “càng lớn càng tốt” (và điều này vẫn thường đúng), và cuộc đua AI chủ yếu xoay quanh việc tiếp cận nhiều hơn sức mạnh tính toán và tài nguyên năng lượng. Tuy nhiên, Trung Quốc đã cho thấy rằng hiệu quả thuật toán và các mô hình mã nguồn mở có thể mang lại chất lượng cao hơn với chi phí thấp hơn và tiêu tốn ít năng lượng hơn (Chan và cộng sự, 2025). Phần lớn các mô hình mã nguồn mở thực ra không tiết lộ cách chúng được tạo ra: dữ liệu huấn luyện và diễn trình vẫn thường được giữ bí mật. Những mô hình “mã nguồn mở” này về mặt kỹ thuật chỉ là “trọng số mở” (open-weight): người dùng mới có thể tải xuống các trọng số đã huấn luyện và chạy, cá thể hoá chúng cục bộ, nhưng mã huấn luyện để tái tạo lại mô hình thì không được công bố (Open Source Initiative, 2025).
Dù vậy, điều này vẫn mở rộng đáng kể cạnh tranh và thúc đẩy sự bùng nổ của các mô hình mới được tinh chỉnh, qua đó làm giảm chi phí. Nó cũng khiến việc phát triển chip AI, mô hình ngôn ngữ lớn (LLM) và các nền tảng trở thành vấn đề an ninh quốc gia. Thực tế, một “cuộc chạy đua không gian” về AI đã hình thành giữa Mỹ và Trung Quốc.
Dù Mỹ và Trung Quốc là hai thế lực chính, chiếm phần lớn các mô hình và hạ tầng, vẫn còn một loạt các mô hình khác dẫn đầu là mô hình mã nguồn mở Mistral tại France. Trong khi các mô hình của Mỹ thường sử dụng được nhiều ngôn ngữ và không chỉ được huấn luyện bằng tiếng Anh, chúng vẫn có xu hướng mang thiên kiến theo góc nhìn phương Tây, tiếng Anh và nam giới (phản ánh chính internet). Các mô hình Trung Quốc rõ ràng sử dụng tiếng Trung tốt hơn ChatGPT, nhưng cũng phản ánh di sản văn hóa Trung Quốc từ dữ liệu huấn luyện của chúng.
Một phần của sự thiên kiến này có thể được giảm bớt bằng cách yêu cầu tìm kiếm toàn cầu bằng nhiều ngôn ngữ khác nhau (và khả năng dịch và tìm kiếm ý tưởng đa ngôn ngữ của AI là một tính năng quan trọng), nhưng đôi khi bạn vẫn cần những hiểu biết sâu sắc và tri thức văn hóa của người bản địa.
Hiện nay đang xuất hiện ngày càng nhiều các mô hình mang tính khu vực và văn hóa (được liệt kê và cập nhật trên trang web của chúng tôi), như Latimer – được huấn luyện trên các nguồn dữ liệu được cấp phép và xác minh từ cộng đồng người da đen và da màu – hoặc Mistral Saba, được huấn luyện trên các nguồn tiếng Ả Rập và các ngôn ngữ bản địa của Ấn Độ. Các mô hình phản ánh những điểm tham chiếu văn hóa từ dữ liệu huấn luyện của chúng, vì vậy việc thử nhiều mô hình khác nhau là rất quan trọng.
Giao diện lập trình ứng dụng (API)
Khi iPhone kết nối internet với điện thoại, chúng ta nhanh chóng nhận ra rằng không cần biết thông tin về mọi chuyến bay mỗi ngày; điều ta cần chỉ là biết chuyến bay của mình hôm nay có bị trễ hay không. Một ứng dụng của hãng hàng không phù hợp hơn cho nhiệm vụ đó. Các ứng dụng được tạo ra để giúp những tác vụ cụ thể trở nên nhanh hơn và dễ dàng hơn.
Giống như các ứng dụng trên điện thoại, các ứng dụng chuyên biệt, thường được tinh chỉnh và sử dụng API, sẽ giúp tập trung cách bạn tương tác với các mô hình nền tảng. Thực tế, OpenAI Store được xây dựng theo mô hình Apple App Store và cung cấp các “GPT” cá thể hoá. Bạn cũng có thể tự tinh chỉnh ứng dụng của mình từ dòng mô hình LLaMA đã được huấn luyện sẵn.
Một nhóm các công cụ nghiên cứu học thuật (ví dụ như Elicit, Consensus và ResearchRabbit) kết nối ChatGPT với cơ sở dữ liệu của Semantic Scholar gồm 175 triệu bài báo, nhằm đảm bảo việc tìm kiếm dẫn bạn hoặc sinh viên của bạn tới các nghiên cứu đã được xuất bản. Với dữ liệu và CÂU LỆNH phù hợp (“chỉ tìm kiếm các nguồn học thuật trong các tạp chí X, sử dụng phương pháp Y và xác minh tất cả liên kết”), bạn có thể tái tạo nhiều tính năng của chúng, nhưng đôi khi một công cụ chuyên biệt với giao diện thân thiện sẽ hữu ích và nhanh hơn so với việc xây dựng các CÂU LỆNH phức tạp.
LearnLM (từ Google), ChatGPT Edu (từ OpenAI), và Tutor Mode (từ BoodleBox) đều được tinh chỉnh để trở thành các thầy dạy kèm hội thoại tốt hơn trong giáo dục, và rõ ràng các tập đoàn công nghệ lớn xem giáo dục là một thị trường tiềm năng.
LearnLM là một phiên bản của Gemini được huấn luyện thêm để khuyến khích học tập chủ động, quản lý tải nhận thức, tăng cường siêu nhận thức (metacognition), kích thích sự tò mò và thích ứng với nhu cầu của người học (Jurenka và cộng sự, 2024). Một phần những điều này bạn có thể thực hiện bằng các CÂU LỆNH riêng lẻ, nhưng LearnLM cho phép AI học và thích nghi trong khuôn khổ sư phạm này; các tương tác và đánh giá bổ sung từ sinh viên và giáo viên đã giúp nó làm được điều đó. (Nếu việc viết CÂU LỆNH giống như đưa ra một công thức, thì fine-tuning giống như dạy AI cách nấu ăn.) Cách tiếp cận này cũng giúp tránh được nhiều hạn chế phổ biến khi dùng AI tổng quát để dạy học: đưa sẵn đáp án, gây quá tải thông tin, và đồng ý với mọi điều người học nói.
Dòng trên cùng của hình 1.1 cho thấy các mô hình ngôn ngữ lớn (LLM) chủ yếu của Mỹ. Bên dưới là một loạt các công cụ API. Phần lớn trong số này tương tác với ChatGPT vì đây là sản phẩm ra mắt sớm nhất, nhưng điều đó sẽ thay đổi theo thời gian. Microsoft và Google đang tích hợp trực tiếp AI của họ, Microsoft Copilot và Gemini, vào các sản phẩm khác, và bạn có thể thêm các tiện ích mở rộng để tóm tắt video YouTube hoặc lập kế hoạch cho kỳ nghỉ trên Expedia. Bạn sẽ không thể theo dõi hết tất cả các hệ thống AI đang “ẩn mình” trong cuộc sống của bạn (và đừng nghĩ quá nhiều về việc các công ty bảo hiểm, nhà quảng cáo hay chính phủ có thể làm gì với dữ liệu mà chiếc xe của bạn biết về bạn), nhưng sẽ rất hữu ích nếu bạn biết rằng có nhiều công cụ khác nhau đang tận dụng API trên thị trường, cũng như mỗi công cụ có thể thực hiện những nhiệm vụ cụ thể nào (và công cụ nào làm tốt hơn công cụ khác). Đây chắc chắn là một phần của năng lực hiểu biết về AI (AI literacy) mà tất cả chúng ta cần phát triển.
AI không phải là điều mới: nó đã định hình bảng tin mạng xã hội và các đề xuất trên Amazon của bạn trong nhiều năm. Tuy nhiên, làn sóng AI mới đang xuất hiện công khai này thì khác. Trước đây, AI giúp “chọn lọc” thế giới của bạn (những gì bạn nhìn thấy và đọc trực tuyến), còn AI dựa trên Generative Pre-trained Transformer giờ đây cho phép bạn tạo ra thế giới của mình.
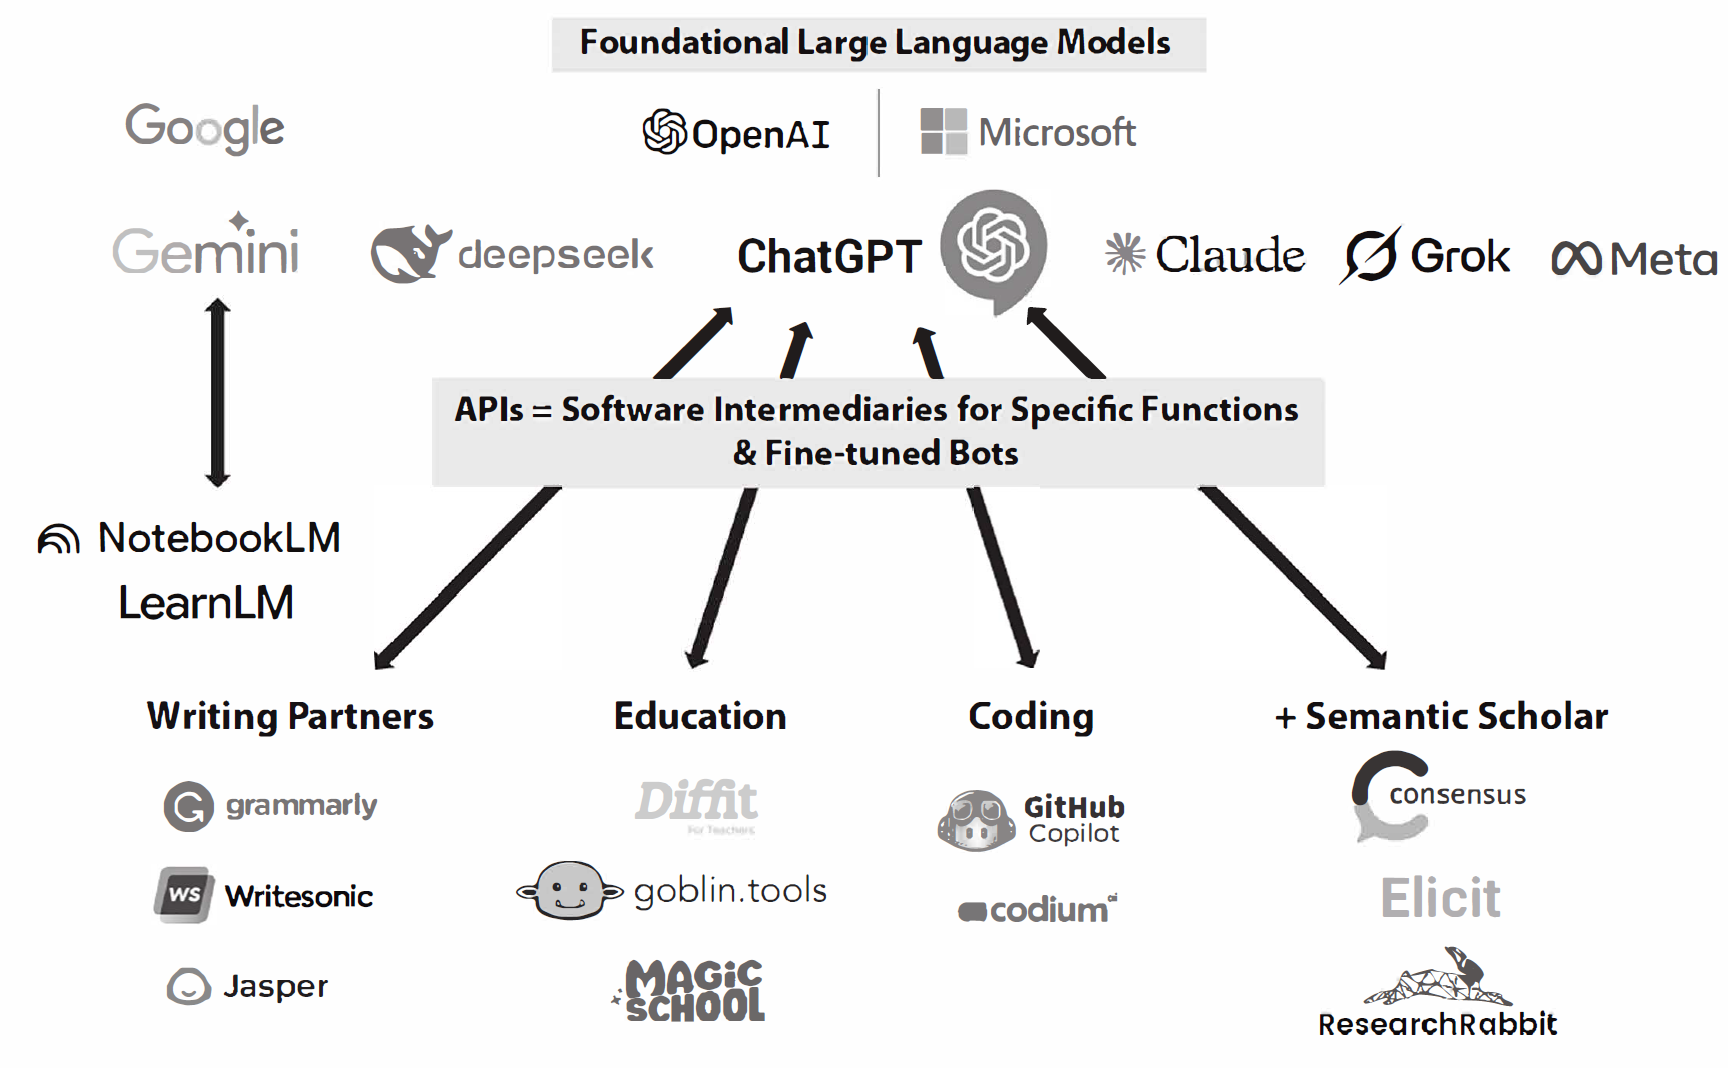
Hình 1.1: Dòng trên cùng hiển thị các mô hình ngôn ngữ lớn nền tảng (LLM) khác nhau, cùng với một số “ứng dụng” phần mềm tương tác với chúng thông qua các API.
Chúng ta mới chỉ bắt đầu khám phá những gì AI tạo sinh có thể làm được, nhưng hiểu biết về AI sẽ trở thành một kỹ năng thiết yếu trong công việc và cuộc sống đối với cả giảng viên lẫn sinh viên. Thực tế, nó đã nhanh chóng trở thành một kết quả học tập thiết yếu của giáo dục đại học.
Chúng ta cần tích hợp năng lực hiểu biết về AI vào trong lớp học, nhưng trước hết cần hiểu rõ AI đang thay đổi công việc và tương lai nghề nghiệp của sinh viên như thế nào.